Почему выбрать ИИ-сервис сложнее, чем кажется
Пользователь открывает десять вкладок подряд: везде обещание «умного помощника», везде похожие скриншоты чата и похожие фразы про скорость и удобство. Через полчаса становится ясно, что один сервис отлично пишет письмо клиенту, а на просьбу разобрать код отвечает общими словами — и наоборот. Слово «нейросеть» здесь работает как ярлык на банке без состава: под ним может скрываться конкретная модель, готовое приложение с интерфейсом, обертка над чужим API или полноценный агент с набором инструментов. Пока пользователь не различает эти уровни, любой выбор превращается в лотерею.
Типичная ошибка — смотреть только на популярность бренда или брать бесплатный тариф, не читая лимиты сообщений и размер файлов. Вторая ошибка — сравнивать инструменты для разных задач: удобство генератора картинок не говорит ничего о качестве анализа договора. Третья — забыть про приватность и скрытую стоимость: бесплатный доступ часто означает, что запросы используются для обучения модели. Задача этого материала не назвать одного победителя, а дать карту рынка ИИ инструменты онлайн и рабочие критерии выбора — именно это редакция вкладывает в фразу «все про нейросети». Разобраться в теме способен любой пользователь, если задать правильные вопросы до регистрации, а не после. материалы ModelStation о моделях и агентах собирают часть таких разборов по конкретным сценариям, и это неплохая точка старта, если критерии выбора из следующего раздела покажутся абстрактными. Отдельный источник методологии — подход к управлению рисками ИИ, где качество и безопасность оцениваются системно, а не по одному красивому примеру.
Что такое нейросеть, модель, сервис и AI-агент
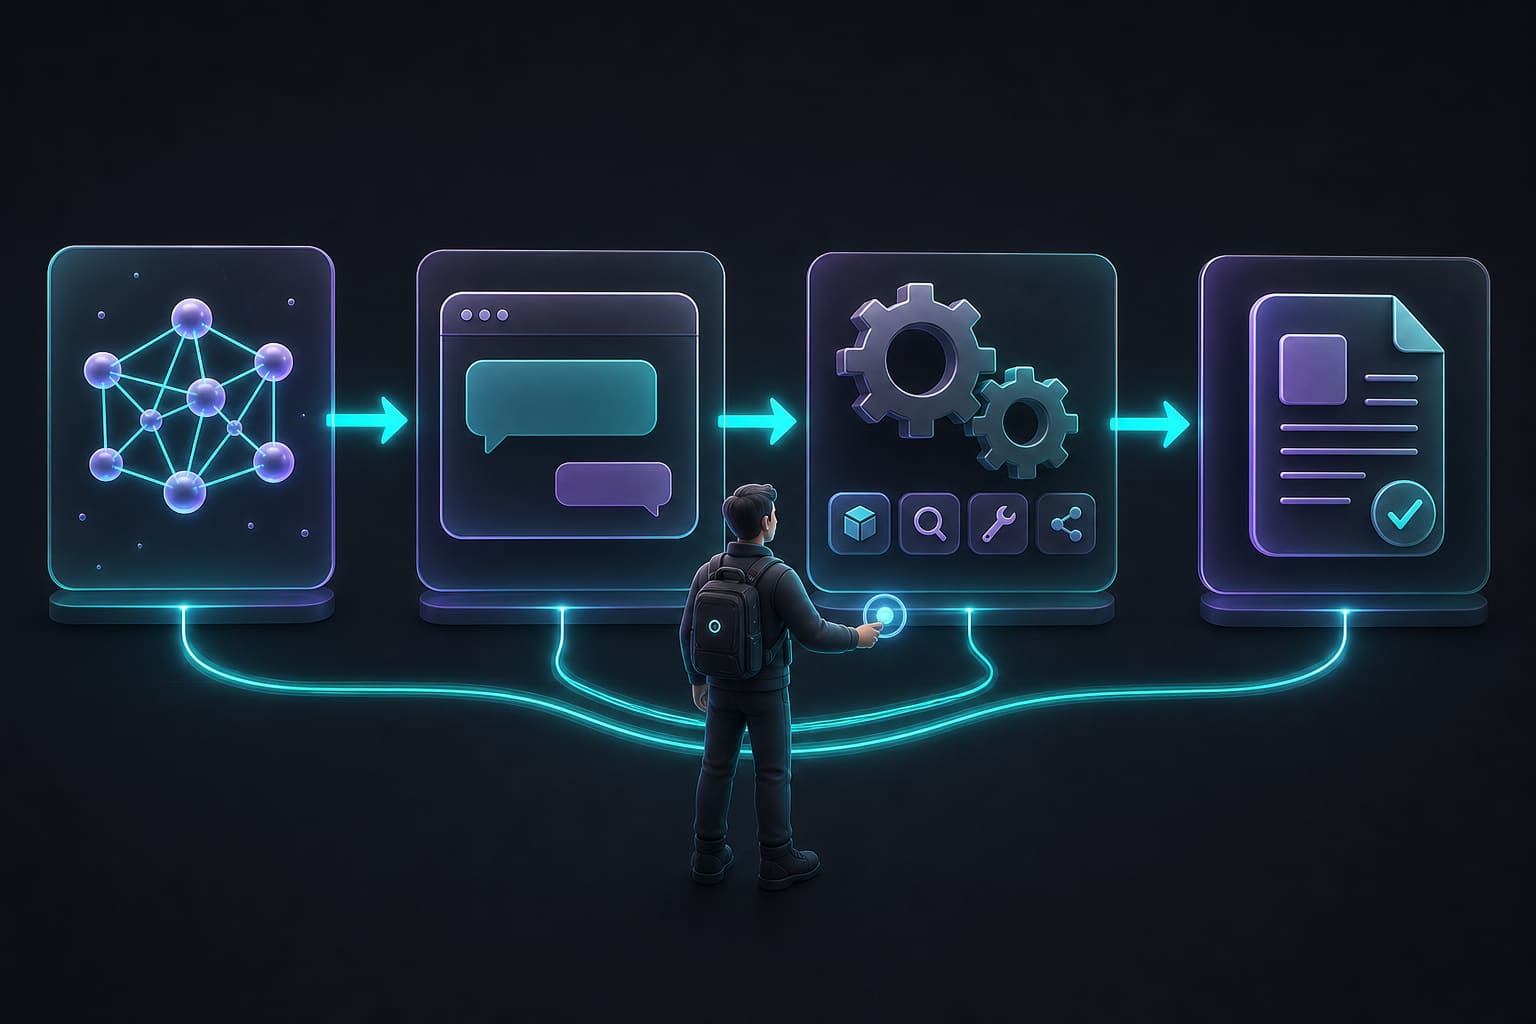
Нейросеть — это вычислительная модель, обученная находить закономерности в данных: тексте, изображениях, звуке или коде. Модель — конкретная реализация такой сети с определенными весами и возможностями: например, одна модель хорошо пишет код, другая — точнее переводит. Сервис — оболочка, через которую пользователь отправляет запрос модели и получает результат: кнопки, поля ввода, история диалога. Агент — это уже связка роли, инструкций, конкретной модели и набора инструментов, способная довести задачу до результата без ручного повторения одних и тех же команд. Бытовой пример: нейросеть — двигатель, модель — конкретная сборка этого двигателя, сервис — приборная панель автомобиля, агент — водитель с маршрутом и правилами движения.
Модель против приложения
Один и тот же сервис часто предлагает несколько моделей одновременно — быструю для черновиков и более мощную для сложного анализа. Поэтому название бренда само по себе не говорит о качестве: важно, какая именно модель отвечает на конкретный запрос и в каком режиме.
Агент против обычного чата
Агент не является автономным и не застрахован от ошибок: он действует строго в рамках заданной роли и инструкций, а результат все равно требует проверки человеком. Запросы «нейросеть ии онлайн» и «нейросеть аи онлайн» обычно обозначают один и тот же класс решений, но смотреть в статье стоит не на название, а на реальную задачу и интерфейс — иначе выбор снова превращается в гадание. каталог AI-агентов ModelStation показывает, как выглядят такие связки роли и инструментов на практике, а объяснение принципа работы нейронных сетей дает более подробную техническую базу термина.
Какие задачи решают ИИ-инструменты онлайн
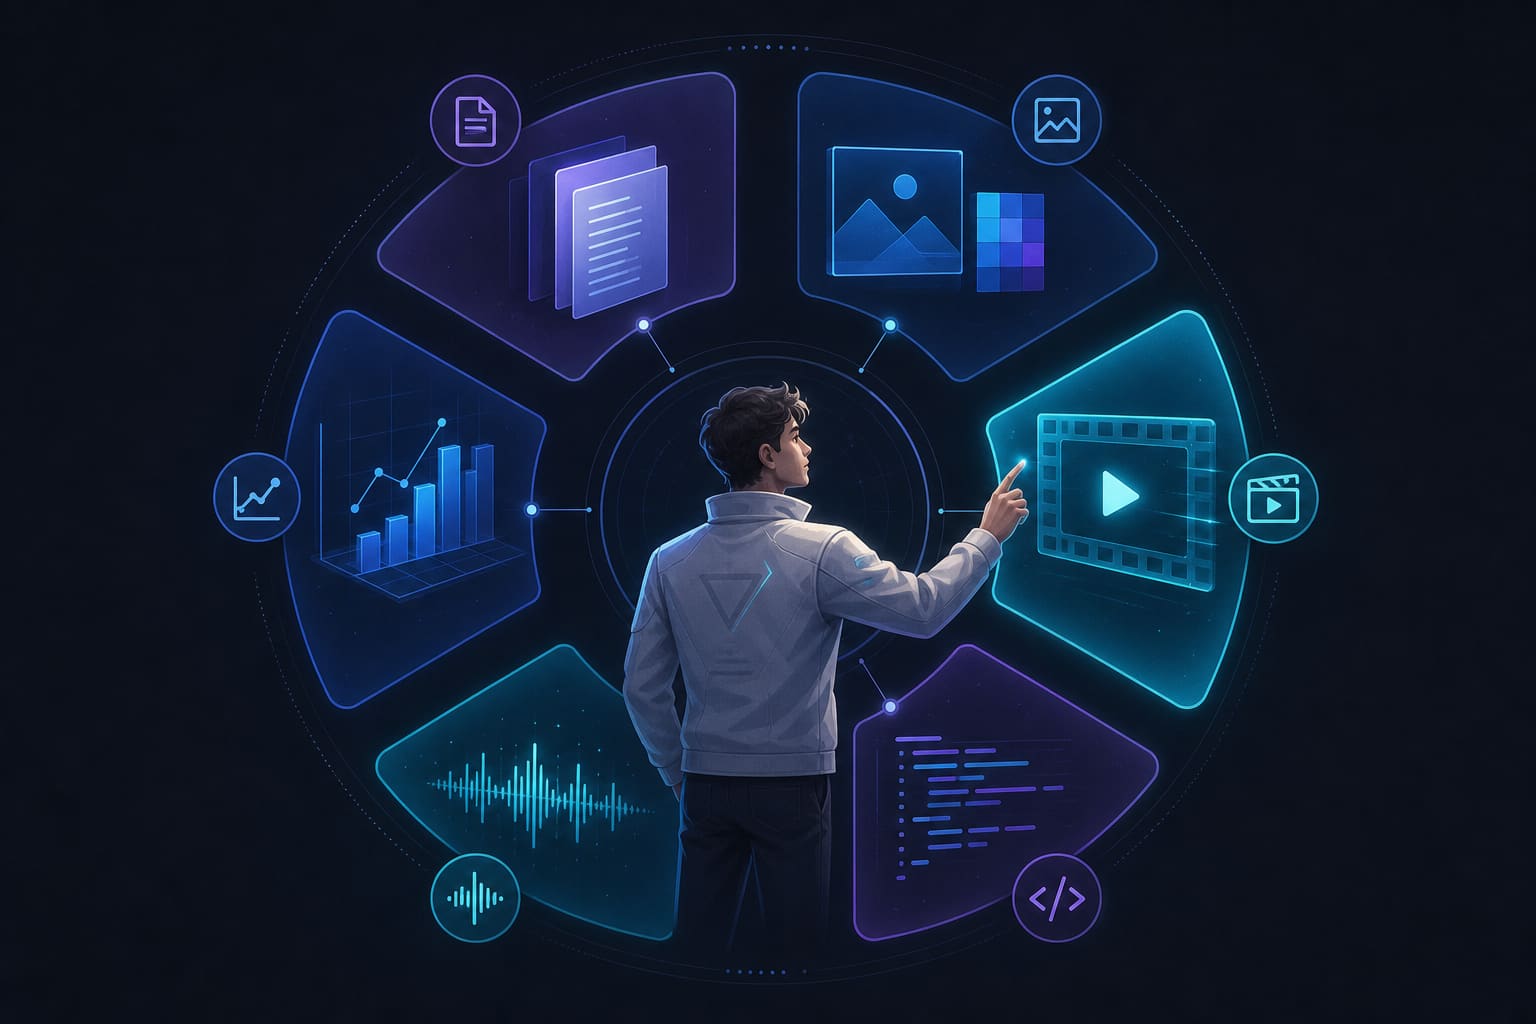
Вместо каталога брендов полезнее держать в голове карту задач. Инструменты условно делятся на работу с текстом, документами, изображениями, видео, аудио, кодом, поиском, аналитикой и автоматизацией процессов. Универсальный чат удобен как точка входа для любой из этих задач, но специализированная модель почти всегда точнее в одной конкретной операции: генератор изображений лучше держит композицию, чем универсальная текстовая модель, а модель для кода реже путает синтаксис языка, чем модель общего назначения.
Категории задач и ожидаемый результат
- Текст — черновик статьи, деловое письмо, план материала;
- документы — выжимка договора, сводка протокола совещания;
- изображения — визуал карточки товара, иллюстрация, портрет;
- видео и аудио — расшифровка встречи, короткий ролик, синтез речи;
- код — функция, тест, объяснение чужого фрагмента, SQL-запрос;
- аналитика — сводка таблицы, поиск аномалий, план кампании.
Пользователь из Москвы или Санкт-Петербурга редко решает только одну задачу за день: утром — анализ таблицы с расходами, днем — правка изображения для карточки на маркетплейсе, вечером — проверка кода перед деплоем. Такому человеку важнее быстро переключаться между режимами внутри одного пространства, чем держать десяток разрозненных подписок ради каждой отдельной задачи. ИИ здесь нужен не только для текстов — сама карта задач это и доказывает. генерация изображений в ModelStation и готовые агенты для текста анализа и кода показывают, как разные категории закрываются внутри одного интерфейса, а обзор применения искусственного интеллекта подтверждает широту прикладных сценариев на уровне международной практики.
Как выбрать нейросеть под конкретную задачу
Правильный вопрос звучит не «какая нейросеть лучшая», а «что мне нужно получить и с каким допуском на ошибку». Ответ на вопрос как выбрать нейросеть начинается не со списка сервисов, а с формулировки результата: короткое письмо клиенту, разбор длинного договора или серия изображений для маркетплейса — три задачи с абсолютно разными критериями.
Алгоритм выбора
- Сформулировать конечный результат и формат ответа.
- Определить тип входных данных — текст, файл, изображение, таблица.
- Задать допустимую ошибку: письмо клиенту прощает погрешность стиля, договор — нет.
- Оценить нужную скорость и частоту использования задачи.
- Установить бюджетный потолок на месяц или на конкретный проект.
В письме клиенту решают тон и скорость ответа, в договоре — полнота контекста и аккуратность формулировок, в изображениях для карточки товара — управляемость стиля и возможность точечной правки без пересборки всей картинки.
Чек-лист минимального теста
- Один и тот же запрос и один и тот же исходный файл для всех кандидатов.
- Фиксация времени ответа и итоговой стоимости запроса.
- Подсчет числа ручных правок до приемлемого результата.
- Список фактических ошибок, а не общее впечатление «хорошо/плохо».
Рейтинг модели — не приговор: он показывает усредненную оценку по чужим задачам, а не гарантию результата на конкретном промпте читателя. рейтинг моделей ModelStation полезен как стартовая точка для отбора кандидатов, а не как финальный вердикт. фреймворк оценки рисков ИИ и принципы ответственного ИИ дают более системный взгляд на критерии качества и ответственного применения.
Текстовые модели: письма, статьи, идеи и анализ
Текстовые модели наиболее полезны в планировании материала, редактировании, переводе, суммаризации длинных документов, подготовке деловой переписки и извлечении тезисов из массива данных. Красивый слог не означает фактическую точность: модель может уверенно и грамотно изложить неверную дату или несуществующую ссылку. Рабочая проверка выглядит так: модели дают один и тот же фрагмент документа и просят отдельно назвать факты, отдельно — неизвестные места, отдельно — собственные выводы. Если модель смешивает эти три категории в один плавный абзац, доверять результату без сверки нельзя.
Быстрые недорогие модели хорошо справляются с черновиками и типовой перепиской, а более сильные и дорогие модели нужны для сложного анализа — длинного договора, финансового отчета, юридического заключения. Ограничения одинаковы для любой ценовой категории: выдуманные ссылки на источники, потеря условий в длинном документе, повторение шаблонных формулировок и необходимость редакторской проверки перед публикацией. Лучший подход к 2026 году — не искать одну универсальную нейросеть онлайн, а сравнивать ответы нескольких моделей в одном окне на одном и том же тексте: расхождения в фактах сразу заметны, а совпадения повышают доверие к выводу. сравнение текстовых моделей по рейтингу и цене удобно использовать именно для такого сопоставления. Первичные технические детали работы с текстовыми моделями описаны в официальном руководстве по работе с текстовыми моделями и в документации Anthropic.
Генераторы изображений и редактирование визуала
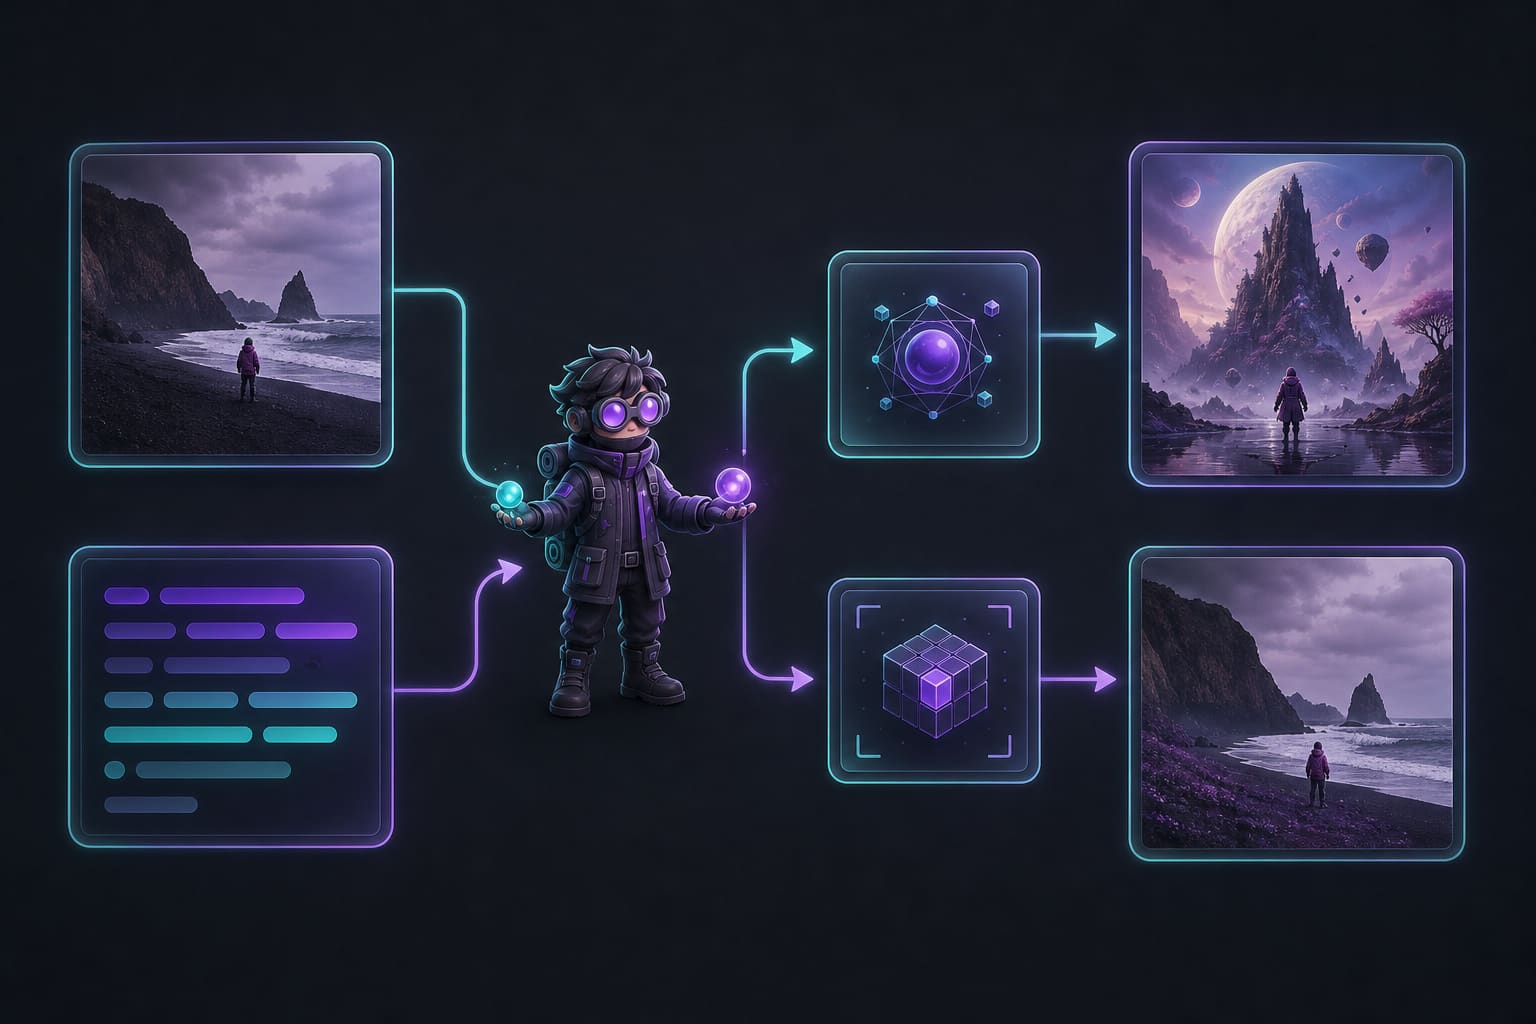
Выбор визуального инструмента ИИ зависит от того, что нужно получить: изображение с нуля, замену фона, удаление лишнего объекта, портрет или карточку товара для маркетплейса. Text-to-image создает картинку по текстовому описанию и подходит для иллюстраций и концептов; image-to-image берет исходную фотографию и меняет её по запросу, сохраняя композицию, — этот режим важнее для коммерческого контента, где лицо, ракурс и пропорции должны остаться узнаваемыми.
Генерация или редактирование: как выбрать
Если исходника нет и нужна свежая иллюстрация — подходит генерация с нуля. Если есть готовая фотография товара и нужно только заменить фон или убрать лишний предмет — почти всегда выгоднее режим редактирования: он меньше искажает то, что уже устраивает заказчика.
Рабочий сценарий для специалиста по контенту: загрузить исходник, четко сформулировать задачу и формат, сгенерировать несколько вариантов, сравнить их между собой и провести финальную ручную проверку каждой детали. Бесплатный генератор не всегда достаточен для коммерческого макета: типичные проблемы — искаженные пальцы и руки, нечитаемый мелкий текст на изображении, случайное совпадение с чужим лицом, вопросы прав на исходные материалы и отсутствие гарантии точного портретного сходства. Инструменты для визуала — это тоже нейросеть в широком смысле слова, и ИИ здесь работает не хуже, чем в тексте, но требует другой методики проверки результата. станция генерации изображений ModelStation и агенты для логотипов портретов и фона закрывают оба сценария — генерацию и точечное редактирование. Технические ориентиры по генерации изображений задают официальная информация о модели Imagen и Adobe Firefly как пример коммерческого инструмента.
Видео, голос и аудио: когда важна скорость результата
Основные сценарии здесь — расшифровка встреч, очистка записи от шумов, синтез речи, перевод аудиодорожки, создание коротких роликов, оживление статичного изображения, монтаж по текстовой команде и генерация фоновой музыки. Требования к аудио и видео выше, чем к обычному текстовому черновику: важны длительность ролика, стабильность внешности персонажа на протяжении всего клипа, синхронизация губ с речью, правильные ударения, уровень шума, авторские права на исходные материалы и корректный экспорт в нужном формате.
Честный тест выглядит так: один и тот же голосовой фрагмент фиксированной длины отправляется в разные инструменты, после чего сравниваются время обработки, число заметных артефактов и возможность внести повторную правку без пересборки всего файла с нуля. Генеративное видео не заменяет полноценный монтаж во всех случаях: там, где нужна точная синхронизация с брендбуком, ручной цветокор и авторская раскадровка, автоматический инструмент дает только черновой вариант. Инструменты для медиа меняются заметно быстрее, чем текстовые нейросети, поэтому редакция фиксирует дату проверки и конкретную версию продукта, а не полагается на демонстрационные ролики годичной давности. обзоры AI-моделей и агентов обновляются именно с учетом этой особенности рынка. Технологическую базу для распознавания и обработки речи задают официальный Speech-to-Text и AI-функции видеомонтажа Adobe.
ИИ для программирования, SQL и технических задач
В разработке ИИ применяют для объяснения чужого кода, генерации функций, рефакторинга, написания тестов, составления SQL-запросов, поиска ошибок, оформления документации и подготовки технического плана. Ключевое ограничение: код от модели нельзя считать проверенным только потому, что он запускается без ошибок — отсутствие синтаксической ошибки не означает отсутствие логической.
Тестовый контур для кода
Рабочий контур включает изолированную среду выполнения, набор автоматических тестов, проверку зависимостей на актуальные версии, базовый анализ безопасности, контроль лицензий подключаемых библиотек и обязательный просмотр изменений человеком перед мержем. Универсальные модели хорошо объясняют логику и предлагают варианты решения, а специализированные агенты для code review и SQL лучше держат контекст конкретного репозитория и стиль команды.
Для разработчика важны длина контекстного окна, возможность работать с целым репозиторием, а не с одним файлом, поддерживаемые языки программирования, скорость ответа и политика хранения переданного кода на стороне провайдера — к 2026 году это уже стандартный пункт проверки перед подключением любого инструмента. Запрос без контекста почти всегда дает убедительный, но бесполезный ответ: модель выдумывает названия переменных и функций, которых не существует в реальном проекте, если не получает исходный код заранее. Лучший вариант — тестировать инструмент на своем реальном репозитории, а не на демонстрационном примере из документации. агенты Code Review и SQL Helper собраны именно под такие технические сценарии. Дополнительные ориентиры дают официальная документация GitHub Copilot и OWASP Top 10 для приложений с языковыми моделями.
Работа с документами, таблицами и исследованиями
Договоры, отчеты, презентации, таблицы, протоколы совещаний и исследовательские материалы — одна из самых частых задач для ИИ инструменты онлайн в рабочей среде. Безопасный процесс начинается не с загрузки всего файла подряд, а с формулировки цели анализа: что именно нужно найти или проверить. Дальше загружаются только нужные данные, модель получает четкую просьбу отделить факты от предположений и дать ссылку на конкретное место в документе, а не общий пересказ. Финальный шаг всегда ручной — проверка ключевых выводов по исходнику.
Ограничения длинного контекста заметны на практике: модель может пропустить приложение в конце договора, неправильно связать две версии одного документа между собой или уверенно сформулировать вывод из неполных данных, не сообщив об этом читателю. Для таблиц ИИ полезен в объяснении сложных формул, поиске числовых аномалий и подготовке короткой сводки, но без ручной проверки результат нельзя использовать для финансовых или юридически значимых решений — цена ошибки здесь слишком высока. Если процесс анализа документов повторяется регулярно, агент с заранее заданной ролью удобнее обычного чата: не нужно каждый раз заново формулировать инструкцию. агенты Contract Review и Research закрывают именно повторяющиеся сценарии анализа. Перед загрузкой чувствительных документов стоит свериться с политикой конфиденциальности ModelStation, а базовые требования к обработке данных задают руководство по защите персональных данных и Федеральный закон № 152-ФЗ о персональных данных.
Как оценивать качество ответа и не верить уверенной ошибке
Практический протокол проверки выглядит просто: выделить проверяемые утверждения, отдельно отметить мнения модели, запросить источники, сверить даты и цифры с оригиналом, повторить вопрос другими словами и сравнить, изменился ли ответ, сопоставить несколько моделей на одном и том же запросе и, наконец, проверить итоговый результат на исходных данных задачи.
Мини-чек-лист проверки фактов
- Слишком общая формулировка без конкретных условий — сигнал слабого ответа.
- Ссылка на источник, который невозможно найти, — повод не доверять факту.
- Подмена исходного вопроса более удобным для модели — частый прием.
- Чрезмерная уверенность там, где данных объективно недостаточно.
Пример из редакционной практики: при проверке статьи модель просят назвать три самых спорных утверждения и объяснить, откуда взята цифра; при проверке коммерческого предложения — сверить условия с исходным брифом построчно; при проверке технического совета — воспроизвести решение на тестовом стенде, а не поверить описанию «это должно сработать». Ручная проверка не отменяет пользу ИИ, а встраивается в процесс как обязательный шаг: инструмент экономит время на черновике, человек экономит репутацию на финальной сверке. Лучший инструмент в этом смысле — не тот, что реже ошибается, а тот, чьи ошибки проще заметить. Методология системной оценки рисков описана в управление рисками и проверка ИИ, а агент Honest AI в ModelStation изначально настроен на разделение проверяемых фактов и предположений.
Стоимость, лимиты и модель оплаты
Цена ИИ-сервиса складывается не из одной цифры на сайте: сюда входят подписка, лимит сообщений в сутки, стоимость токенов, максимальный размер входных файлов, отдельная плата за генерацию изображений, приоритетная скорость ответа и корпоративные условия для команд.
Подписка или оплата по факту использования
Бесплатный тариф подходит для редких задач и знакомства с сервисом, но лимиты и очередь на обработку быстро становятся заметны при регулярной работе. Подписка выгодна, если пользователь постоянно работает с одним сервисом и хочет фиксированный бюджет на месяц — но переплата возникает, если сервис используется нерегулярно. Оплата по факту использования удобна, когда нужны разные модели под разные задачи и не хочется держать несколько параллельных подписок ради каждой из них.
При расчете стоит считать не только цену одного запроса, но и время на переключение между сервисами, число повторных генераций до приемлемого результата, суммарную стоимость нескольких активных подписок и цену возможной ошибки, если результат не проверен вовремя. Бесплатный сервис не всегда дешевле: скрытая цена в виде потраченного времени и качества часто выше стоимости платного тарифа. На данных ModelStation тарифы отображаются в долларах США за 100 000 токенов, а конкретные цифры по каждой модели и рейтинг стоимости стоит смотреть непосредственно на цены ModelStation на момент обращения, поскольку условия провайдеров меняются. Оценку моделей по соотношению цены и качества дает рейтинг и стоимость моделей. Логику токеновой оплаты у крупных провайдеров можно увидеть в официальной странице цен OpenAI API и в официальных ценах Gemini API — это полезный ориентир перед выбором модели оплаты в 2026 году.
Доступность сервисов в России и работа онлайн
Доступность конкретного ИИ-сервиса в России зависит от нескольких факторов сразу: региона, возможности регистрации, способа оплаты, политики провайдера и текущих лимитов конкретного продукта, и эти условия способны меняться без предупреждения. Обещать универсальный доступ ко всем зарубежным сервисам без оговорок нельзя — вместо этого полезнее знать порядок проверки.
Практический порядок такой: проверить, открывается ли нужный интерфейс из своего региона, можно ли создать аккаунт, есть ли русский язык интерфейса, какой способ оплаты принимается, поддерживается ли импорт файлов и сохраняется ли история переписки между сессиями. Агрегатор моделей полезен именно в этой точке: несколько зарубежных и российских моделей доступны через единое пространство и единый баланс, и не нужно проходить процедуру регистрации и оплаты отдельно для каждого сервиса. Это не отменяет технических и правовых ограничений: агрегатор не гарантирует, что любая модель всегда будет доступна, а условия использования нужно читать так же внимательно, как и для отдельного сервиса. Прежде чем передавать чувствительные данные, стоит изучить политику хранения конкретного продукта, а не полагаться на общее впечатление удобства. о ModelStation описывает назначение и аудиторию агрегатора, а условия использования ModelStation фиксируют конкретные правила работы сервиса. Правовой контекст обработки данных в России задает закон о персональных данных, а динамику регулирования на другом рынке показывает регуляторная рамка ИИ в ЕС.
Приватность, персональные данные и коммерческая тайна
Прежде чем загрузить документ в любой сервис, полезно мысленно разложить данные по уровням: открытая информация, рабочие материалы без личных идентификаторов, персональные данные, медицинские сведения, финансовые документы, исходный код и коммерческая тайна. Для каждого уровня есть свое безопасное поведение: открытые материалы можно отправлять без ограничений, рабочие данные — обезличить и убрать лишние поля, персональные и финансовые сведения — либо не отправлять вовсе, либо использовать только корпоративный контур с отдельным договором.
Значок замка в интерфейсе сервиса не доказывает полную безопасность данных: это технический признак шифрования канала связи, а не гарантия того, что запросы не используются для дообучения модели. Политику конфиденциальности стоит читать до загрузки документов, а не после инцидента. Сервису имеет смысл задать конкретные вопросы: где физически хранятся данные, используются ли запросы пользователя для обучения модели, кто из сотрудников провайдера имеет доступ к переписке, как удалить историю запросов полностью, есть ли отдельное управление командой и ведется ли журнал действий пользователей. Лучший инструмент по качеству ответа не отменяет этой проверки: редакция не рекомендует передавать чувствительные данные во внешний сервис только ради удобства одного запроса. Прочитать актуальные условия можно в политика конфиденциальности ModelStation, а базовые правовые ориентиры задают Федеральный закон о персональных данных и руководство по защите данных ICO.
AI-агенты и автоматизация повторяющихся процессов
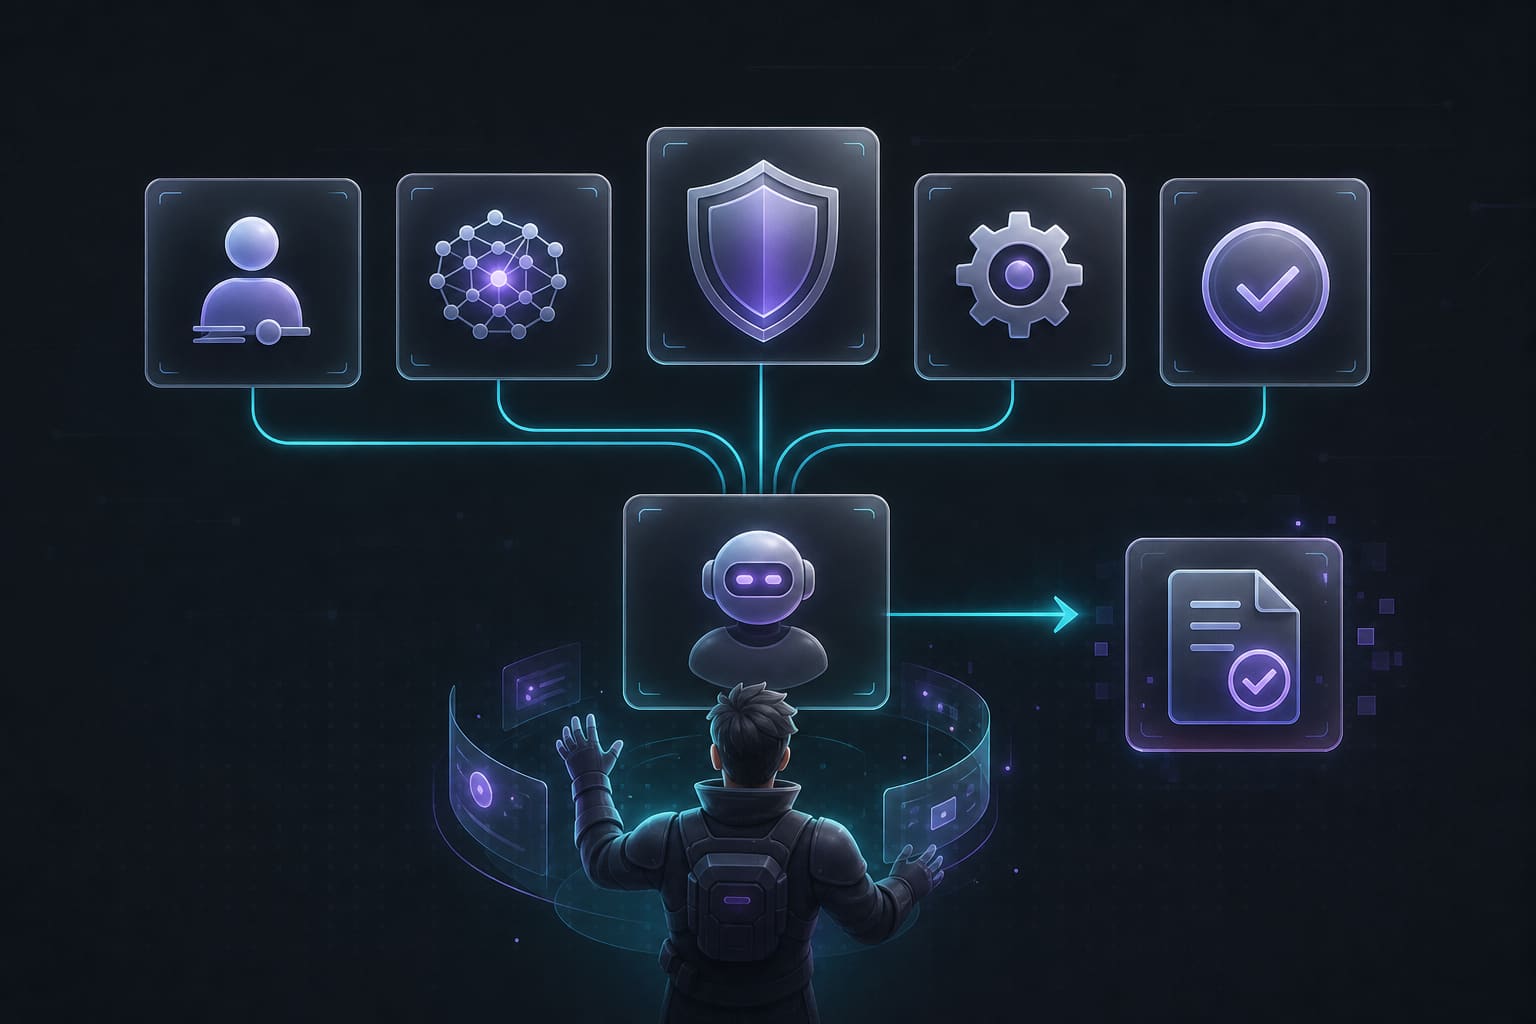
Обычного чата достаточно для разовой задачи, но когда операция повторяется каждую неделю, требует определенной роли, фиксированного формата ответа и последовательности действий — нужен агент. Сценарии встречаются в редакции при регулярной проверке фактов, в маркетинге при подготовке однотипных описаний товаров, в аналитике при разборе одинаковых отчетов, в разработке при code review и в поддержке при обработке типовых обращений.
Структура хорошего агента
Рабочий агент состоит из пяти частей: роль, входные данные, ограничения, формат результата и критерии остановки, после которых обязательна проверка человеком. В ModelStation такие роли уже собраны под конкретные задачи: Honest AI отделяет проверенные факты от предположений, Contract Review разбирает договоры, Decision Compare сравнивает варианты решений, Code Review проверяет код, SQL Helper составляет запросы к базе данных, Copywriter готовит рекламные и продающие тексты, а Research собирает и структурирует информацию по теме.
Ни одной из этих ролей не стоит приписывать автономность, которой у нее нет: агент действует строго в рамках заданных правил и может ошибаться на каждом шаге, поэтому финальное решение всегда остается за владельцем процесса. Агенты нужны не только крупному бизнесу — небольшая команда из трех человек экономит на автоматизации ровно тот же процент времени, что и большая компания, если процесс действительно повторяется, а не выполняется раз в квартал. ИИ здесь работает как ускоритель рутины, а не как замена ответственного за результат. Разные роли и сценарии собраны в каталог агентов ModelStation, а место агентов в общей архитектуре сервиса описывает единое рабочее пространство ModelStation. Более подробный разбор архитектуры агентных систем дает исследование об эффективных агентах.
Как сравнивать несколько моделей на одном запросе
Честное сравнение начинается с фиксации условий: одна и та же задача, одни и те же исходные данные, одинаковые ограничения по объему и формату, единые критерии оценки. Дальше один запрос отправляется нескольким моделям одновременно, и сравниваются полнота ответа, фактическая точность, стиль, скорость получения результата, стоимость запроса и число ручных правок до готового варианта. Выбирать победителя по одному красивому примеру нельзя: модель может случайно попасть в удачный ответ и провалить похожую задачу через минуту.
Критерии по типу задачи
Для текста важны структура и фактическая точность, для кода — прохождение тестов и отсутствие уязвимостей, для изображений — сходство с исходником и управляемость стиля, для аналитики — прозрачность рассуждения и наличие ссылок на конкретные данные.
ModelStation AI Arena дает возможность увидеть два ответа рядом при одинаковом контексте, а также время генерации и расход токенов по каждому варианту — это удобно именно для быстрого сопоставления без переключения между вкладками. Результат такого сравнения относится к конкретному тесту на конкретных данных, а не переносится автоматически на все будущие задачи пользователя: лучший вариант сегодня может уступить завтра на другом типе запроса. Каталог для предварительного отбора участников теста — рейтинг моделей ModelStation, а сама механика параллельного сравнения реализована в AI Arena ModelStation. Похожий публичный принцип сравнительной оценки языковых моделей применяет публичная арена сравнения языковых моделей.
Что дает агрегатор моделей в одном интерфейсе
Агрегатор моделей решает конкретную практическую проблему: не нужно регистрироваться в десятке сервисов и оплачивать столько же подписок ради разных задач. ModelStation объединяет модели разных провайдеров в одном рабочем пространстве, дает единый баланс для оплаты, позволяет переключаться между моделями внутри одного диалога, сравнивать ответы, использовать готовых агентов под типовые задачи и обращаться к генерации изображений без отдельного аккаунта.
Единый баланс, память, мультивыбор и арена моделей
Единый баланс означает, что деньги списываются только за фактически потраченные токены конкретной модели, а не за неиспользованные лимиты простаивающей подписки. Память диалога сохраняется в рамках выбранного пространства, мультивыбор позволяет отправить один запрос нескольким моделям сразу, а арена моделей показывает ответы рядом для честного сравнения.
Экономический эффект нагляден: пользователь не обязан заранее покупать несколько подписок, стоимость зависит от выбранной модели и размера конкретной задачи, а перед отправкой запроса видна применяемая ставка. История запросов помогает контролировать расходы постфактум и находить задачи, которые обходятся дороже остальных. Ограничения тоже стоит держать в уме: доступность конкретной модели у конкретного провайдера способна измениться, качество результата все равно зависит от выбранного провайдера, а единый интерфейс не отменяет необходимости проверять результат вручную — это правило работает одинаково что для отдельного сервиса, что для агрегатора. Лучший сценарий использования агрегатора — не поиск идеальной единственной модели, а быстрое переключение между несколькими проверенными вариантами под конкретную задачу; именно так задача статьи «все про нейросети» превращается в рабочий инструмент, а не в бесконечный список названий. Возможности сервиса описаны на странице ModelStation: модели в одном пространстве, модель оплаты — на странице оплата ModelStation по факту использования, а сравнение доступных вариантов — в рейтинг доступных моделей. Системный подход к управлению такими AI-процессами описывает международный стандарт управления ИИ.
Итог
Выбор ИИ-инструмента онлайн перестает быть лотереей, если сначала сформулировать задачу, а потом искать под неё модель, а не наоборот.
- Модель, сервис и агент — разные уровни одной системы: модель дает возможности, сервис дает доступ, агент организует повторяющийся процесс, и ни один уровень не заменяет проверку результата человеком.
- Карта задач важнее каталога брендов: текст, документы, изображения, видео, аудио, код и аналитика требуют разных критериев оценки и разной методики теста.
- Качество, скорость, стоимость, лимиты, приватность и доступность в России — шесть параметров, которые стоит проверять до, а не после загрузки чувствительных данных.
- Самостоятельная работа с десятком отдельных сервисов и работа через единое пространство с общим балансом решают одну и ту же задачу разными способами: агрегатор экономит время на переключении, но не отменяет проверку результата.
- Короткий тест на реальной задаче с фиксацией времени, стоимости и числа правок дает более честный ответ, чем любой готовый рейтинг моделей.
Данные проверены на 4 сентября 2026 года.