Что именно умеет генерация видео ИИ
Пользователь открывает ленту, видит эффектный ролик и пробует повторить результат — но вместо кинематографичной сцены получает набор артефактов. Разгадка не в везении, а в том, что генерация видео ИИ работает по-разному в зависимости от режима и входных данных.
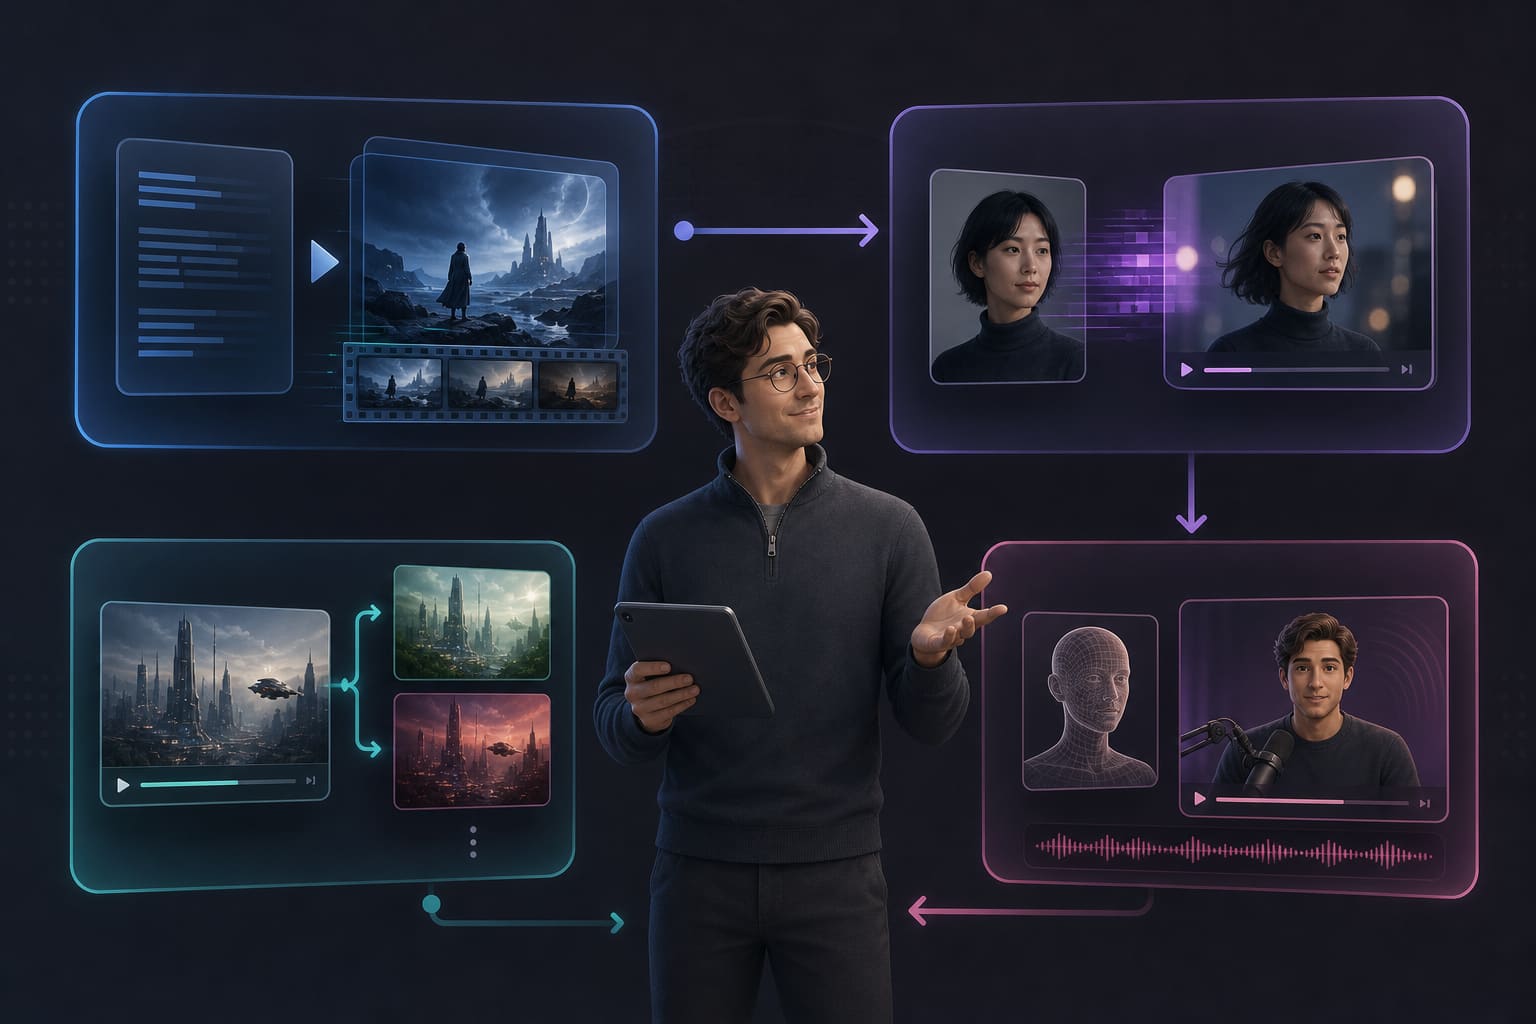
Существует четыре базовых режима. Text-to-video строит сцену из текстового описания — ничего, кроме промпта, не требуется, но контроль над внешностью героя минимальный. Image-to-video оживляет загруженную фотографию: модель сохраняет композицию снимка и добавляет движение по описанию. Video-to-video берёт готовый клип и переносит на него стиль, фон или освещение, сохраняя исходную динамику. Четвёртый режим — аватар по сценарию: текст выступления превращается в говорящего персонажа с синхронизацией губ.
У каждого режима свои сильные стороны и границы. Модель хорошо держит общий свет, композицию кадра и плавное движение камеры. Хуже обстоит дело с руками и мелкими предметами, нестабильным лицом при смене ракурса, нечитаемым текстом в кадре и непредсказуемой физикой — вода, ткань, волосы часто ведут себя неестественно. Длительность одной генерации обычно короткая, счёт идёт на секунды, а не на минуты.
Один и тот же сюжет про чашку кофе на столе можно получить тремя путями: описать текстом паровой узор и свет, оживить фотографию чашки лёгким движением пара или записать аватара, который рассказывает про сорт кофе. Критерии проверки в каждом случае разные: для первого — правдоподобность сцены, для второго — сохранение формы чашки, для третьего — синхронность губ и голоса. Ии сделать видео по одной короткой фразе и сразу получить готовый материал для публикации не получится — нейросеть сделать видео может быстро, но черновой вариант почти всегда требует доработки и монтажа.
Типы входных данных и контроль результата
Текстовый запрос даёт максимум творческой свободы и минимум контроля над внешностью объектов. Фотография фиксирует композицию и силуэт, но ограничивает диапазон возможных действий. Готовый клип передаёт движение камеры и ритм, однако итоговое качество зависит от резкости и стабильности исходника — размытый или тёмный клип модель не улучшает, а лишь переносит на него стиль.
Как подготовить идею, сценарий и исходники
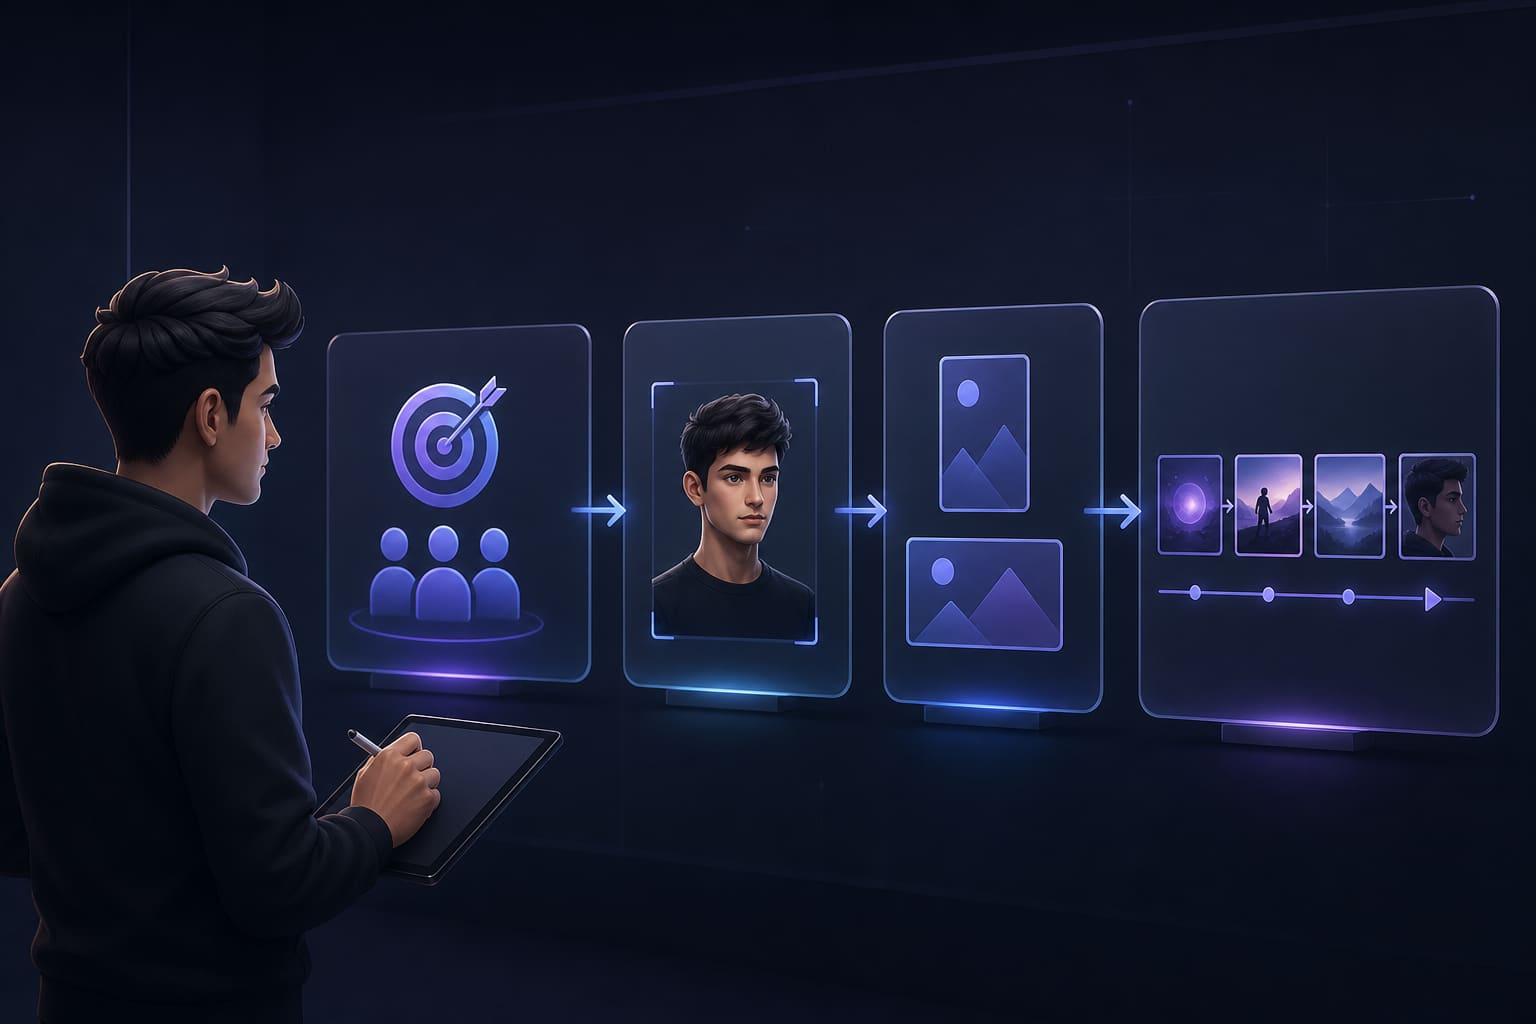
Качество результата определяется до открытия генератора. Первый шаг — не промпт, а бриф: цель материала, аудитория, площадка публикации, формат кадра, длительность, ключевое действие и нужная эмоция. Без этого набора даже удачная генерация окажется бесполезной — ролик для сторис в формате 9:16 не подойдёт для презентации в 16:9.
Длинный сюжет лучше сразу разложить на сцены по 3–10 секунд — именно такой длительностью управляют большинство генеративных моделей без потери качества. Рекламный ролик с несколькими товарами стоит разбить на отдельные планы: один план — один товар, одно действие, один ракурс. Как создать анимацию ИИ без переделок: сначала декомпозиция, потом генерация, а не наоборот.
Для исходной фотографии действуют простые требования: один главный объект в кадре, резкость без размытия движения, понятный силуэт на контрастном фоне, отсутствие лишних людей и деталей, которые модель может случайно изменить — часы, надписи на одежде, мелкий узор. Создать видео с помощью нейросети из размытого снимка с толпой на фоне почти всегда даёт непредсказуемый результат.
Для аватара подготовка иная: текст выступления проверяется на длину фраз, расставляются паузы перед сложными словами, отдельно выписывается произношение имён и терминов, а главное — заранее собирается согласие человека на использование его внешности и голоса, если аватар основан на реальном лице. Сделать видео через ии с живым человеком в кадре без такого согласия — прямой путь к удалению материала с площадки.
Идея «сделать красивый ролик» превращается в рабочее описание через пять вопросов: кто в кадре, что происходит, где находится герой, как движется камера, какой свет нужен и что менять запрещено. Подробный бриф нужен не только профессиональной студии — любительский проект без него превращается в бесконечный перебор случайных генераций.
Карточка проекта перед стартом
Мини-бриф перед запуском включает: цель, аудиторию, площадку, формат кадра, длительность, главный объект, основное действие, визуальный стиль, наличие звука, список ограничений и критерий приёмки — то есть признак, по которому результат признаётся готовым, а не очередным черновиком.
Как написать промпт для управляемой сцены
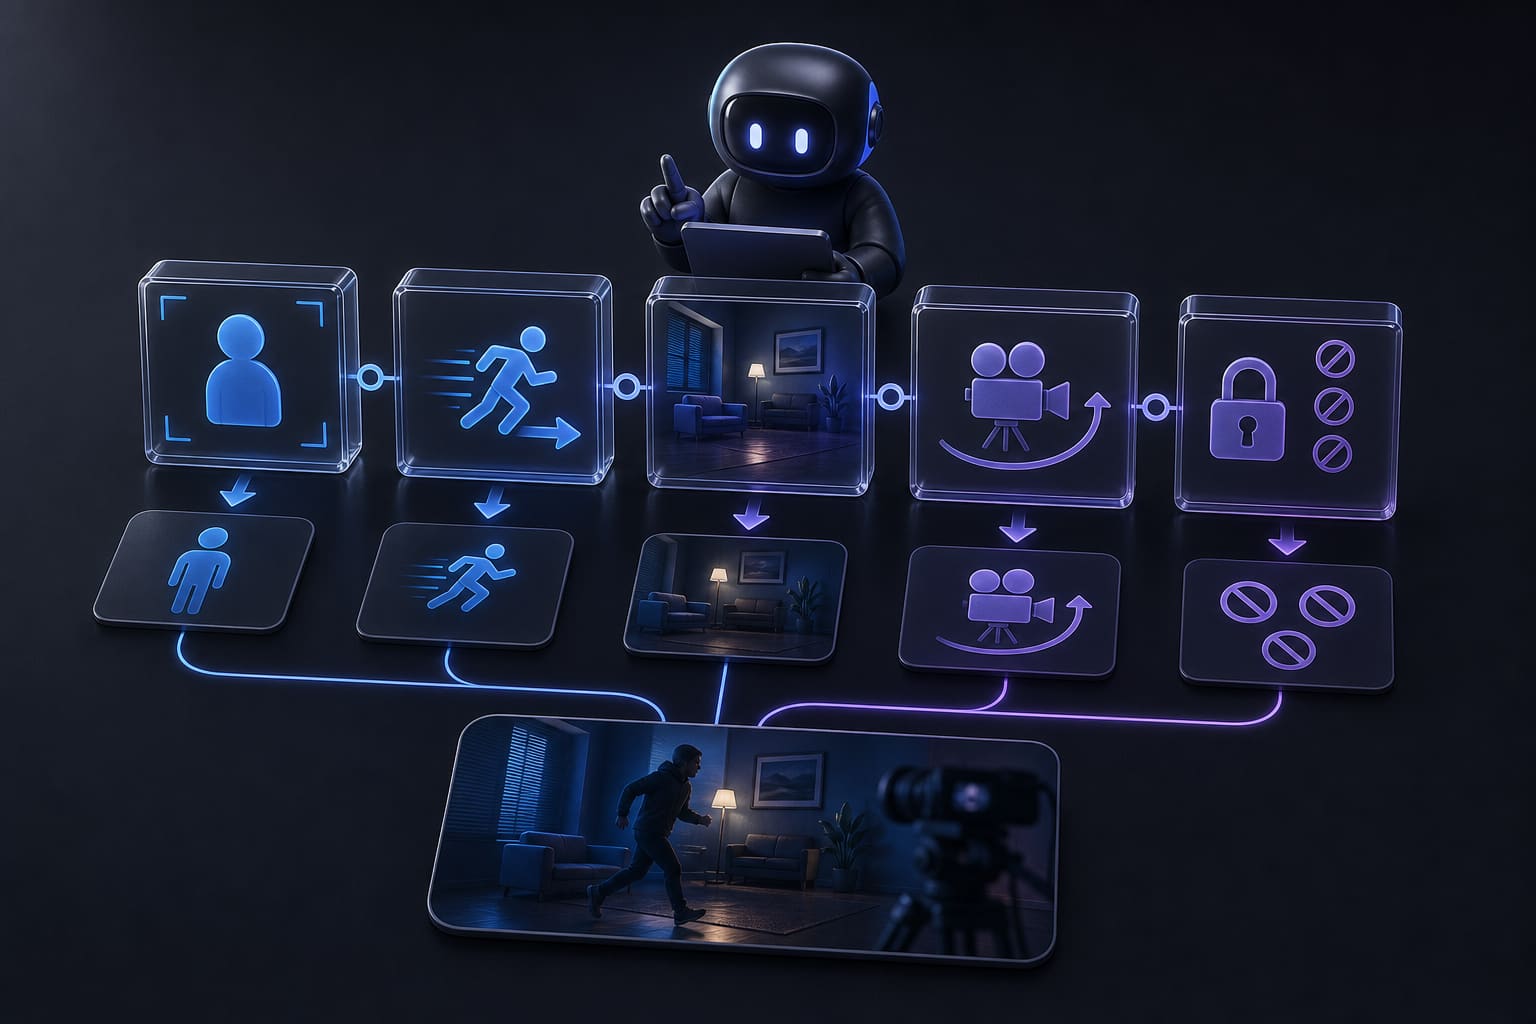
Рабочий промпт строится из пяти блоков: субъект, действие, окружение, камера, ограничения. Субъект — кто или что в кадре: «молодой архитектор в светлой рубашке». Действие — одно ясное событие: «открывает макет здания обеими руками». Окружение — место и атмосфера: «светлая архитектурная студия, большие окна». Камера — движение и ракурс: «камера медленно приближается на уровне груди». Ограничения — что нельзя менять: «лицо и цвет макета не менять, без посторонних людей в кадре».
При работе с изображением логика иная: не нужно заново описывать то, что уже видно на фото — цвет одежды, фон, предметы на столе. Важно задать именно движение и направление камеры, иначе модель начинает додумывать детали, которых не было на исходнике, и персонаж меняется до неузнаваемости.
Одна сцена — одно основное действие. Запрос «герой встаёт, идёт к окну, достаёт телефон и звонит» почти всегда разваливается на нестыкующиеся куски движения. Разделение на четыре отдельные сцены с одинаковым описанием персонажа даёт управляемый результат, который проще собрать монтажом.
Длинный литературный текст не гарантирует лучший результат — ии нейросеть создать видео по пяти чётким блокам получается точнее, чем по абзацу метафор. Сделать видео с помощью нейросети проще с коротким конкретным описанием, чем с поэтичным текстом без фактов о субъекте, действии и камере.
Итерации нужно вести по одному параметру за раз: сначала меняется только свет, затем только ракурс камеры. Удачный исходник сохраняется отдельно, версии сравниваются по заранее заданному критерию — например, стабильности лица, — а не переписывается весь промпт после каждой неудачи.
Пять блоков рабочего промпта
Порядок субъект — действие — окружение — камера — ограничения работает как чек-лист: «девушка в красном пальто» (субъект), «перелистывает страницы книги» (действие), «уютная библиотека с тёплым светом» (окружение), «камера статична, план средний» (камера), «цвет пальто не менять» (ограничения).
Итерации без хаотичной смены запроса
Менять один параметр за раз — правило, которое экономит время: если лицо получилось нестабильным, корректируется только описание лица, а не весь промпт целиком. Удачная версия сохраняется как референс, новая генерация сравнивается с ней по конкретному признаку — совпадению одежды, направлению взгляда или плавности движения.
Как выбрать режим: текст, фото, анимация или аватар
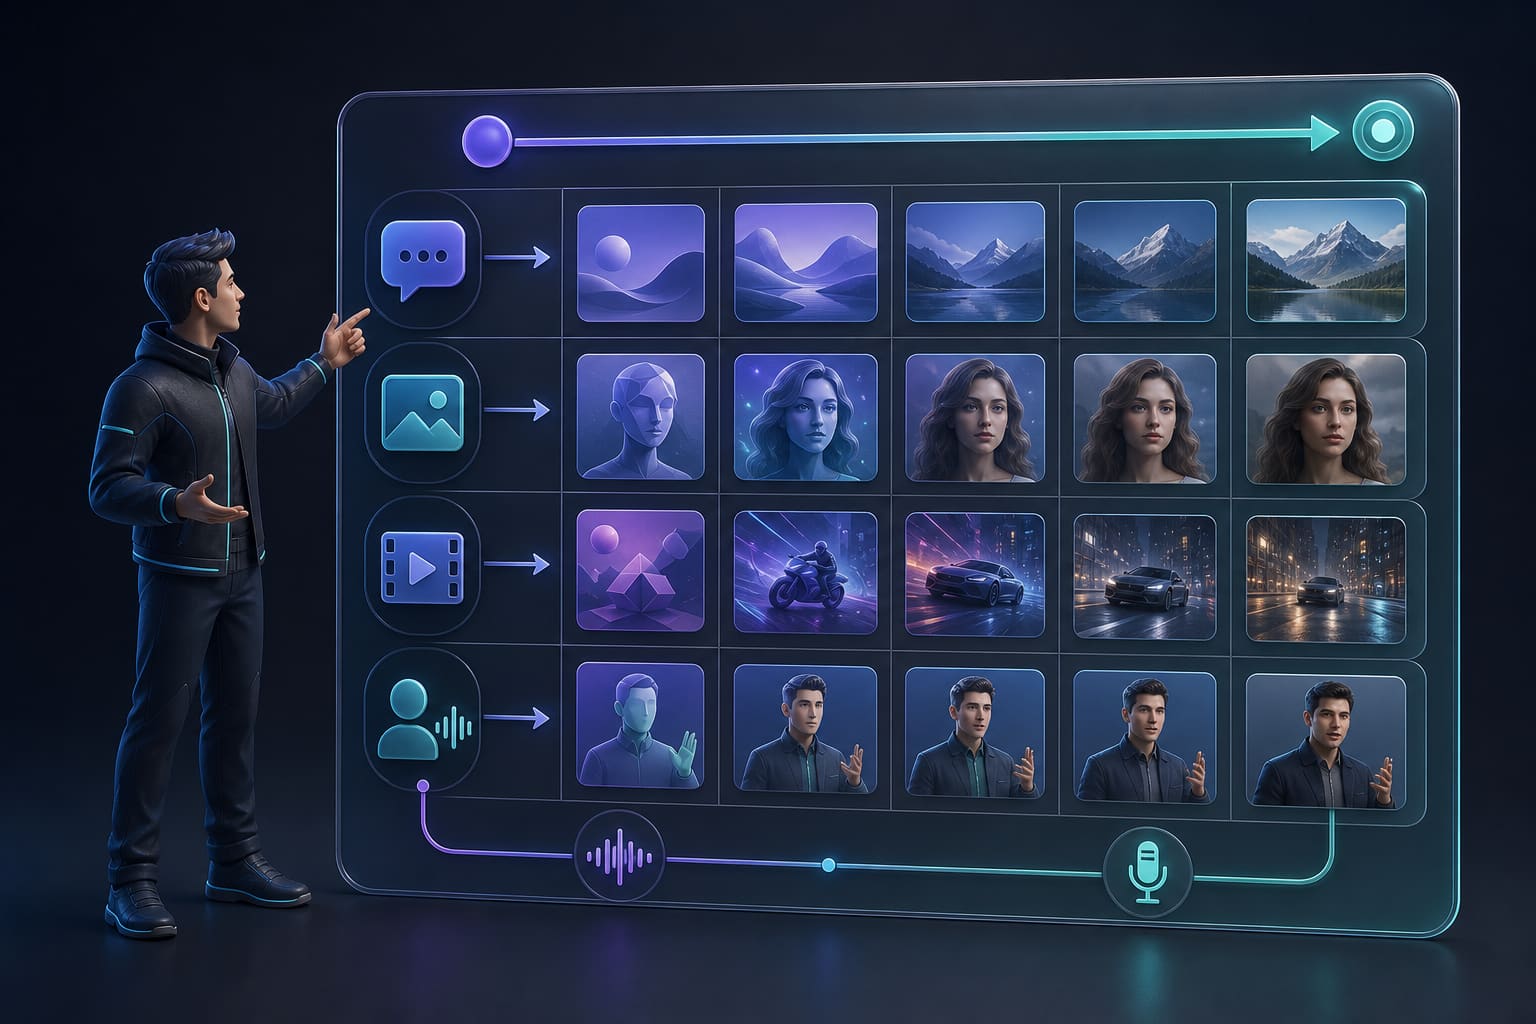
Выбор режима зависит от того, что уже есть на старте и какой уровень контроля нужен. Текстовая генерация подходит для быстрого старта, когда исходника нет вовсе: пользователь описывает идею словами и получает сцену с нуля, но контроль над внешностью героя низкий — лицо и детали могут меняться между дублями.
Изображение-в-видео выигрывает там, где важно сохранить конкретный объект: товар на витрине, портрет человека, персонажа с узнаваемым костюмом. Модель получает готовую композицию и добавляет движение, не придумывая форму и цвет заново.
Video-to-video решает другую задачу — перенос стиля на существующий клип, замену фона или смену освещения. Итоговое качество здесь напрямую зависит от исходного видео: чёткий ровный клип даёт управляемый результат, а дрожащая съёмка с телефона — набор артефактов поверх дрожания.
Аватар — отдельный процесс, не похожий на генерацию кинематографичной сцены. Нужен сценарий, выбор голоса, настройка мимики, синхронизация губ с речью и обязательное соблюдение ограничений на использование лица, если аватар основан на реальном человеке.
Правило выбора простое: сначала оцениваются входные данные и требуемый уровень контроля, затем — качество, скорость генерации, длительность клипа, наличие звука, разрешение и бюджет. Для рекламы товара лучше начинать с чистого фото-референса, для анимации — с изображения или раскадровки, для презентационного ведущего — сразу с аватара. Сделать видео онлайн ии одной универсальной моделью для всех задач не получится: сделать видео нейросетью онлайн эффективно, когда режим подобран под конкретную задачу, а не наоборот.
Выбор режима под задачу
Связка «задача — входной материал — уровень контроля» выглядит так: свободная идея — текст, товар или портрет — фотография, перенос стиля — готовый клип, говорящий ведущий — аватар. Чем точнее совпадает исходник с задачей, тем меньше повторных генераций потребуется.
Пошаговый процесс создания первого ролика
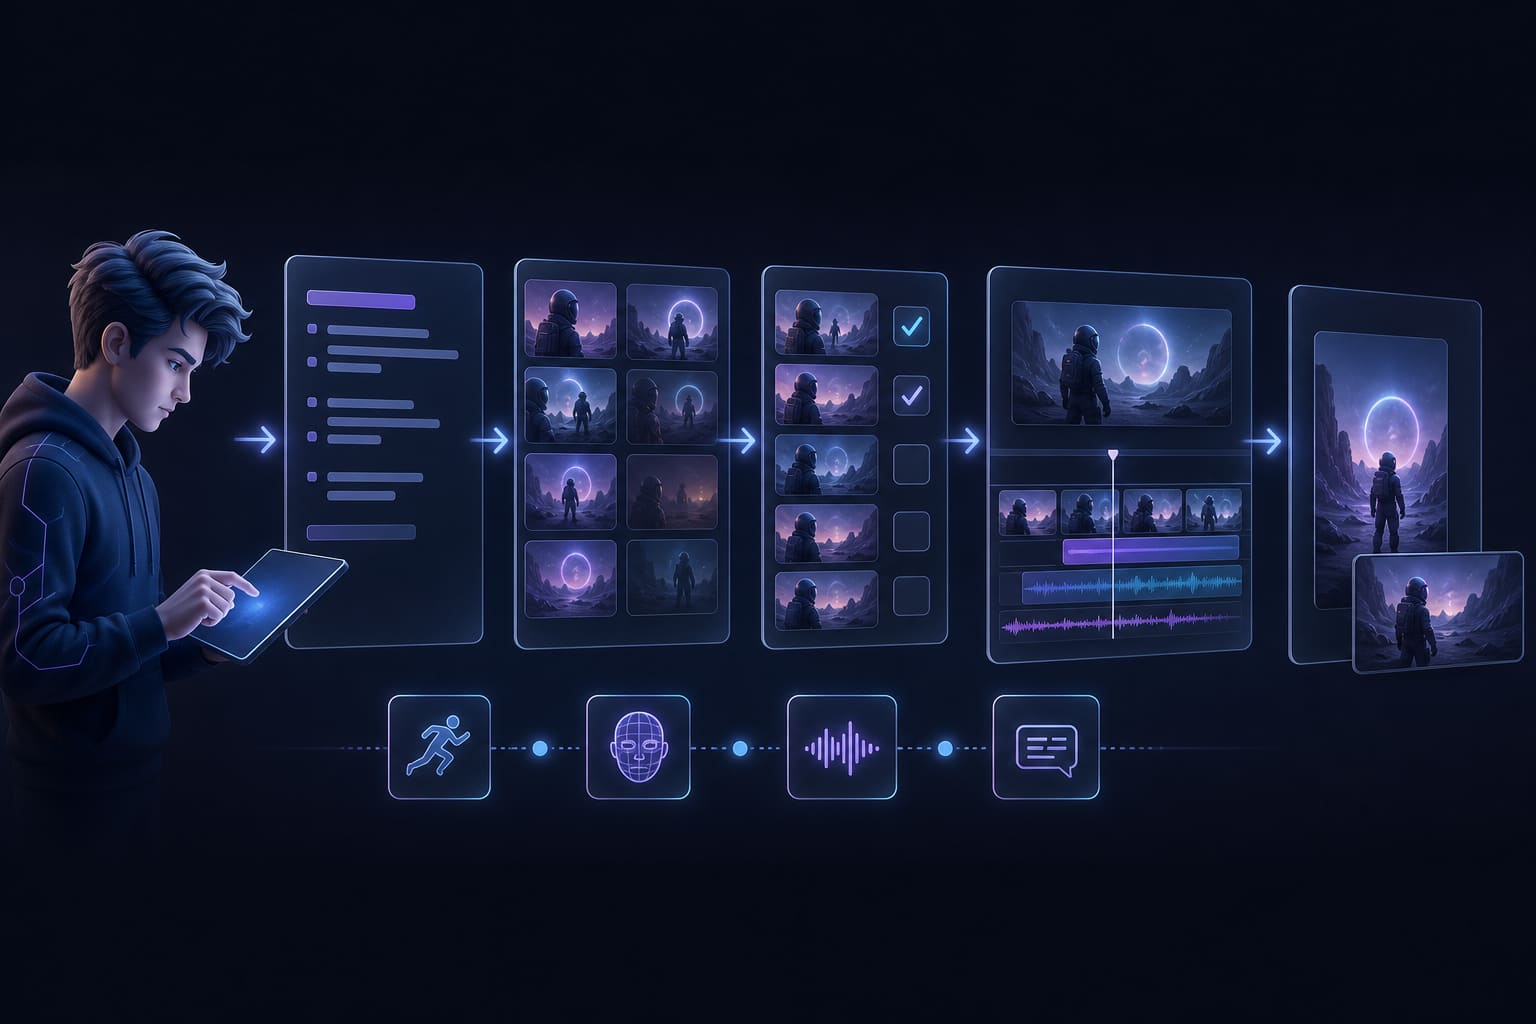
Алгоритм первого запуска состоит из двенадцати понятных шагов. Цель формулируется одной фразой — результат: чёткое представление, зачем нужен материал. Ошибка здесь — слишком общий бриф вроде «что-то красивое про продукт».
Формат выбирается под площадку: 16:9 для YouTube и презентаций, 9:16 для сторис и коротких видео, 1:1 для карусели в соцсетях. Результат — совместимость с местом публикации; ошибка — выбор формата после генерации, когда переделывать уже поздно.
Изображение готовится заранее, если нужен режим image-to-video: один объект, резкий кадр, чистый фон. Короткий промпт пишется по пяти блокам из предыдущего раздела — результат: управляемая сцена; ошибка — один длинный запрос с несколькими событиями сразу.
Длительность и разрешение задаются исходя из лимитов модели — большинство генераций укладываются в несколько секунд при разрешении 720p или выше. Генерация запускается сразу в нескольких вариантах — результат: выбор из альтернатив; ошибка — принятие первой же версии без сравнения.
Лучший дубль отбирается по заранее заданному критерию: стабильность лица, плавность движения, совпадение с исходником. Проблемная сцена повторяется отдельно, а не весь ролик целиком — некоторые дефекты дешевле исправить монтажом, обрезкой лишнего кадра или заменой одной короткой сцены, чем новой полной генерацией.
Отобранные клипы собираются на таймлайне, добавляется голос, музыка, субтитры — и только после этого происходит финальный экспорт. Генерация видео ИИ через нейросеть даёт сырьё, а не готовый материал: сделать видео через нейросеть и создать видео через нейросеть без монтажной сборки означает получить набор разрозненных клипов вместо связного ролика. Смешение разных стилей между сценами и отсутствие финальной проверки текста на экране — типичные причины, почему готовый материал выглядит неряшливо. Бесплатной попытки обычно недостаточно для качественного финала: платный тариф или оплата по факту использования компенсируется экономией времени на повторные генерации.
Параметры первого запуска
Перед нажатием кнопки генерации фиксируются: формат кадра, длительность клипа, разрешение, число параллельных вариантов и требования к исходному изображению — резкость, один объект, чистый фон. Эти параметры редко меняются после запуска, поэтому их стоит выставить осознанно с первой попытки.
Отбор и сборка результата
Удачный дубль выбирается по совпадению с брифом, а не по первому впечатлению. Сцены собираются на монтажной шкале в нужном порядке, явные артефакты вырезаются обрезкой кадра, а недостающие элементы — субтитры, логотип, финальная заставка — добавляются уже на монтаже, а не повторной генерацией.
Как сделать анимацию и сохранить персонажа
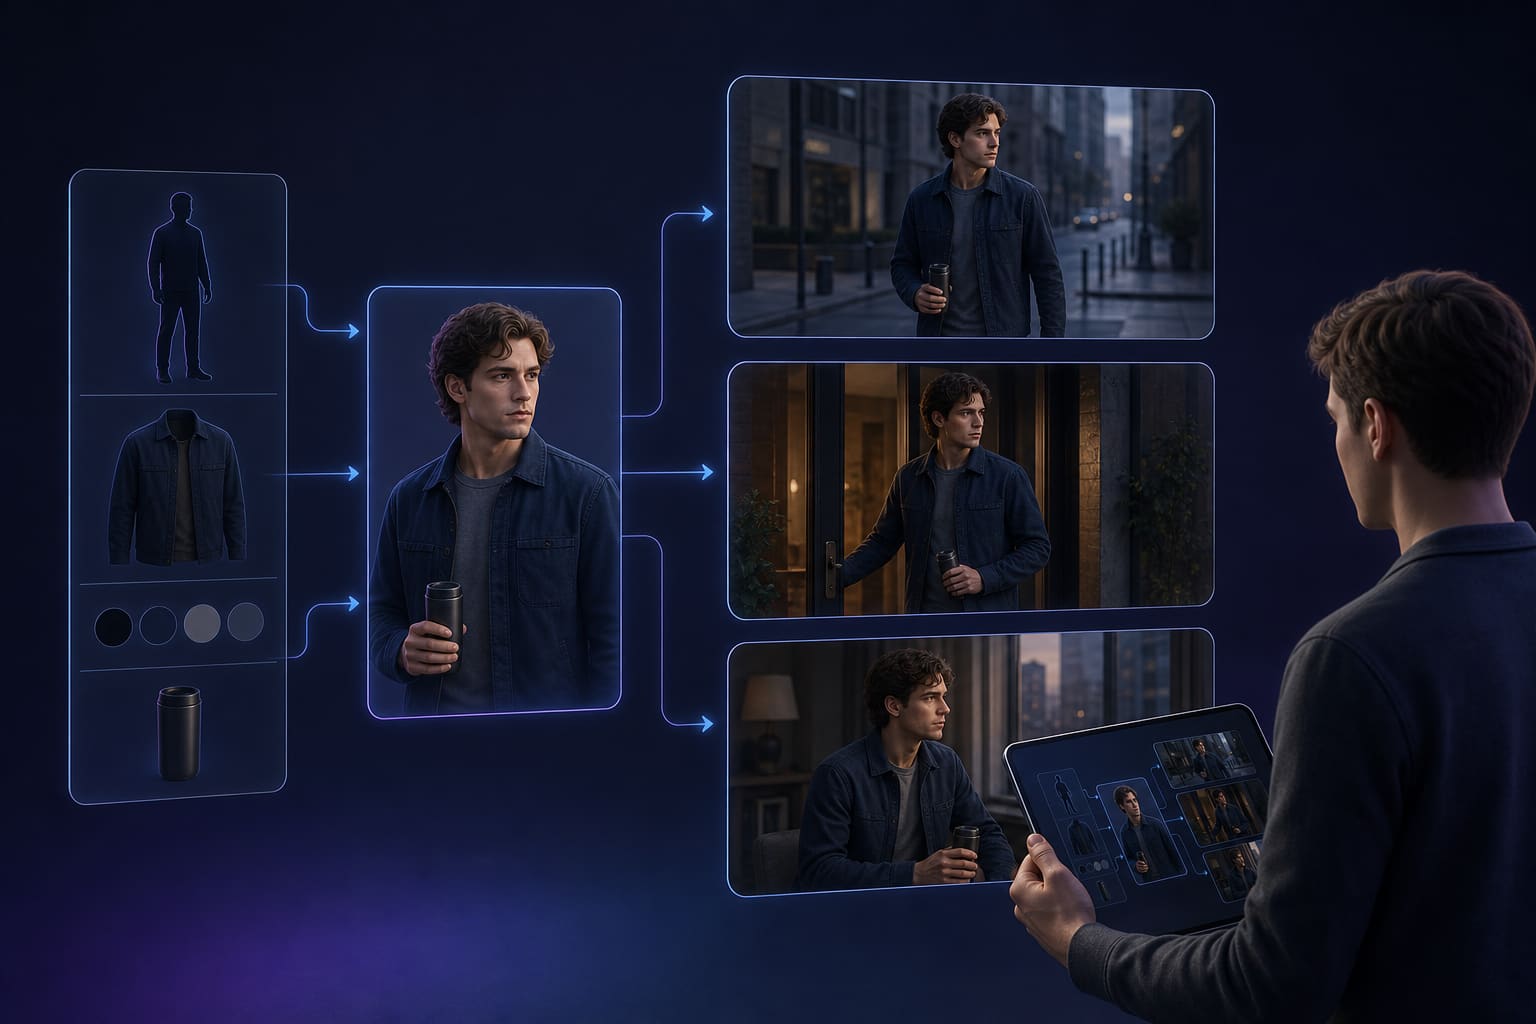
Главная практическая проблема длинной анимации — нестабильность: лицо, одежда, цвет предмета, направление движения и фон могут меняться между соседними дублями, даже если промпт почти не менялся. Как создать анимацию ИИ без рассыпающегося персонажа — вопрос метода, а не удачи.
Метод простой: один референс используется для всех сцен, описание персонажа повторяется дословно в каждом промпте, палитра кадра остаётся неизменной, ракурс камеры фиксируется там, где это возможно, а на каждый клип закладывается одна основная задача — не несколько действий сразу. Видео ии сделать самому получится точнее, если держать эти пять правил при каждой генерации.
Для анимации фотографии лучше задавать малое движение: поворот головы, лёгкое движение камеры, покачивание ветра в волосах — вместо сложного танца с несколькими объектами одновременно. Чем больше одновременных движений в кадре, тем выше риск искажения конечностей и лица. Ии нейросеть сделать видео с резким танцем часто даёт нечитаемые руки и смазанные черты лица именно из-за перегрузки одной генерации множеством движений.
Для персонажа в длинном сюжете полезно вести отдельную карточку героя: внешность, одежда, примерный возраст, ключевой реквизит и список запретов — что нельзя менять ни при каких обстоятельствах. Эта карточка подставляется в каждый новый промпт без изменений.
Более дорогая модель не решает проблему идентичности автоматически — без референсного изображения и ручного контроля персонаж «плывёт» даже в топовых генераторах. Нейросеть сама не знает, что лицо героя должно остаться прежним, если это не задано явно и не подкреплено исходным кадром.
Ограничения генеративных моделей
Типовые артефакты: искажённые пальцы рук, нестабильное лицо при смене ракурса, нечитаемый текст на вывесках и упаковках, неестественная физика ткани и воды, рассинхронизированный звук, резкие скачки между соседними кадрами. Руки и текст обычно исправляются уточнением промпта или заменой кадра, а скачки между сценами и звуковая рассинхронизация чаще решаются уже на монтаже.
Как создать видео с ИИ-аватаром и голосом
Аватарный сценарий устроен иначе, чем генерация кинематографичной сцены. Для него нужны текст выступления, выбранный персонаж или согласованный цифровой двойник, голос, язык и темп речи, фон и формат кадра — набор, близкий скорее к записи студийного ролика, чем к созданию спецэффекта.
Произношение русских имён, терминов и чисел стоит проверять отдельно: модели синтеза речи иногда ставят неверное ударение в редких фамилиях или читают число буквально вместо привычной человеческой формы. Паузы перед сложными словами, естественность жестов и точная синхронизация губ с озвученным текстом — три параметра, которые стоит пересмотреть после первой же генерации, а не принимать как есть. Сделать видео ролик ии с аватаром без этой проверки часто даёт результат с рассинхроном губ в середине фразы.
Три рабочих сценария отличаются по правам и задаче. Готовый библиотечный аватар подходит для объясняющего материала — инструкции, обучающего ролика, презентации продукта, где важна ясность, а не конкретное лицо. Цифровой двойник сотрудника требует отдельного письменного согласия на использование внешности и голоса, иначе материал нельзя публиковать от имени компании. Персонаж без сходства с реальным человеком годится для развлекательного контента, где достаточно выразительности без привязки к конкретной личности.
Подготовка текста для озвучки
Текст для синтеза речи пишется короткими фразами без вложенных конструкций, цифры лучше прописывать словами там, где нужно конкретное произношение, а сложные термины стоит протестировать отдельно до полной генерации. Ии чтоб сделать видео с понятной дикцией — вопрос подготовки текста, а не только выбора модели.
Согласие на использование внешности
Если аватар основан на реальном человеке, требуется явное согласие на использование лица и голоса для конкретной цели — например, для корпоративного видео, а не для любой последующей рекламы. Без зафиксированного согласия публикация материала с узнаваемым человеком создаёт прямой юридический риск для автора и компании.
Аватар не заменяет живую съёмку полностью. Для построения доверия, сложной мимики в эмоциональной рекламе или сцен с живой реакцией человека по-прежнему требуется реальная съёмка — цифровой двойник хорошо справляется с информационным и объясняющим форматом, но не с эмоциональной драматургией.
Как собрать длинный сюжет из коротких сцен
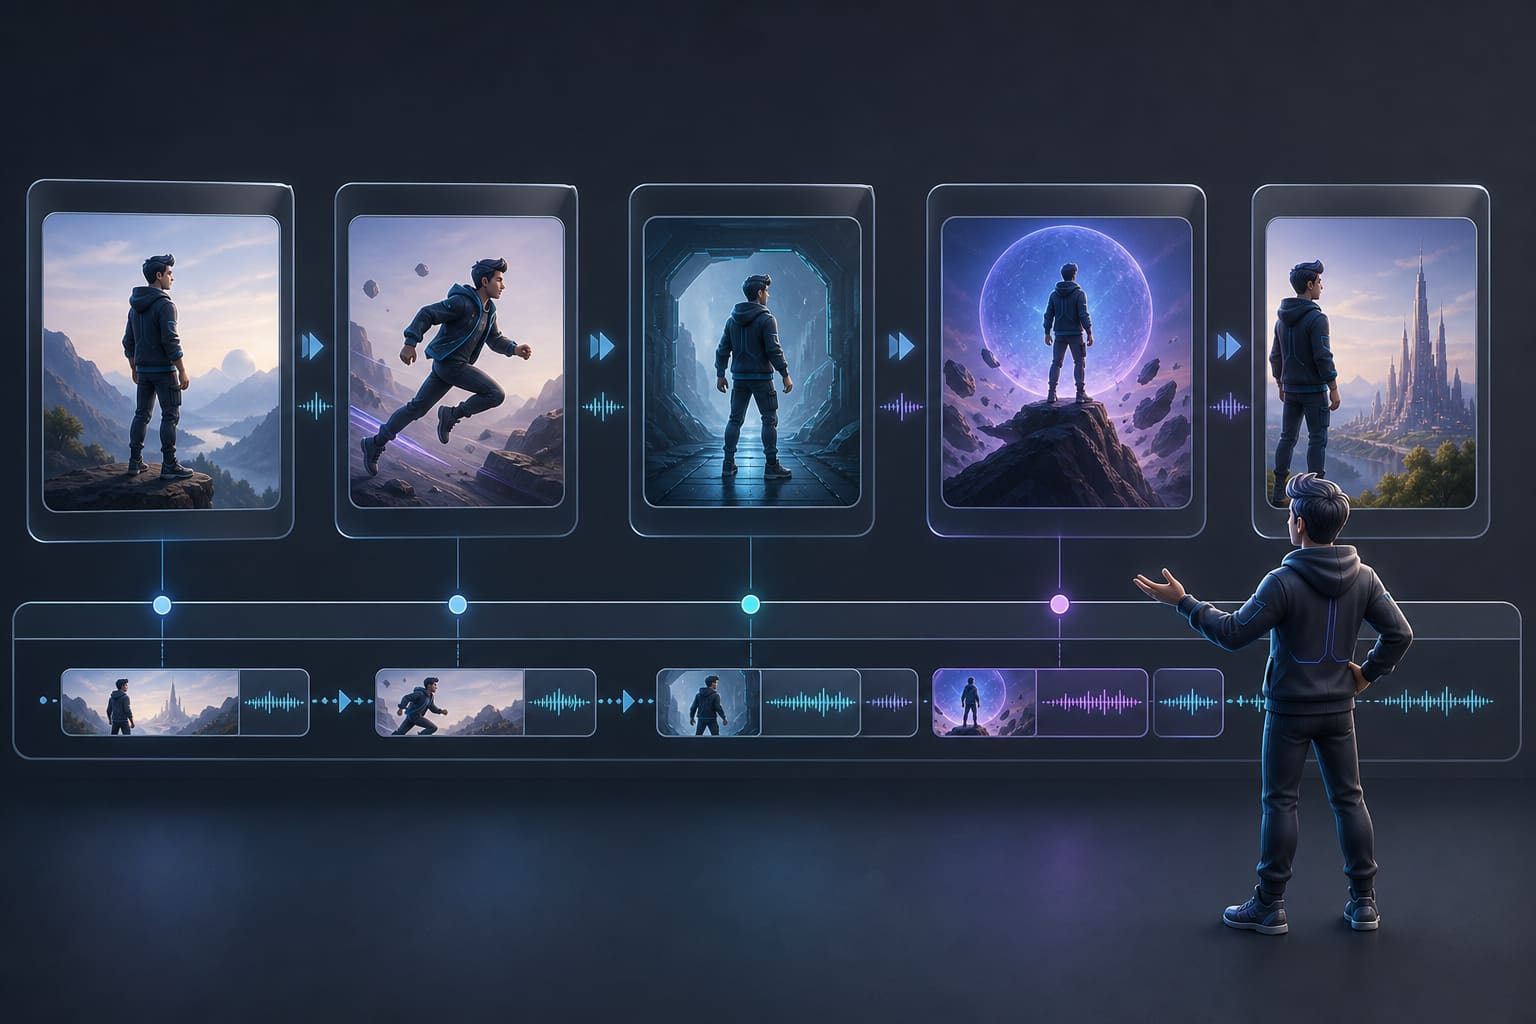
Длинный материал редко получается одним непрерывным запросом — большинство моделей ограничены по длительности одной генерации, а связный сюжет требует управления на каждом шаге. Решение — декомпозиция: завязка, действие, переход, кульминация, финальный кадр, и под каждую часть — отдельная сцена с повторяемым описанием персонажа.
Чтобы избежать визуальных скачков между сценами, каждая из них заканчивается направлением движения, а следующая начинается с похожего положения камеры — герой уходит вправо в конце одной сцены и появляется слева в начале следующей. Единый цветовой сценарий — одна палитра на весь сюжет — удерживает ощущение целостности, а монтаж по ритму музыки или речи сглаживает оставшиеся стыки.
Русский текст в кадре — отдельная тема: генеративные модели часто искажают буквы, поэтому надписи, титры и подписи лучше добавлять на монтаже, а не просить нейросеть нарисовать их внутри сцены. Сделать видео с ии на русском с читаемым текстом проще через наложение готовой графики поверх сгенерированного клипа. Озвучку стоит дополнительно проверять на ударения и правильное произношение имён — автоматическая генерация речи иногда путает редкие слова.
Увеличение длительности генерации само по себе не создаёт связный фильм — без декомпозиции на сцены с повторяемым персонажем длинный клип превращается в череду несвязанных эпизодов. Сделать видео с помощью нейросети онлайн на длинную историю получится только через сборку коротких управляемых фрагментов, а не через один длинный запрос.
Сколько стоит создание и цена ИИ аватаров
Стоимость видео складывается не из одной цифры, а из набора факторов: тариф подписки, расход кредитов за секунду, выбранная длительность, разрешение кадра, конкретная модель внутри сервиса, число повторных попыток при неудачных дублях, перевод на другой язык, клонирование голоса, создание персонального аватара и экспорт без водяного знака. Цена ИИ аватаров формируется именно из этой суммы параметров, а не из рекламной цифры на главной странице сервиса.
Ниже — проверяемые примеры по состоянию на 1 октября 2026 года. Условия тарифов провайдеры меняют без предупреждения, поэтому перед серийной работой стоит свериться с актуальной страницей цен конкретного сервиса.
| Инструмент или режим | Проверяемый параметр | Значение по официальной странице |
|---|---|---|
| Runway Gen-4 Turbo | Расход генерации | 5 кредитов за секунду |
| Runway Gen-4 | Расход генерации | 12 кредитов за секунду |
| Google Veo 3 | Длительность клипа | 4, 6 или 8 секунд |
| Google Veo 3 | Разрешение | 720p или 1080p для поддерживаемых моделей |
| HeyGen Creator | Тариф и пакет | 29 долларов в месяц, 600 кредитов |
| Synthesia Starter | Тариф и пакет | 29 долларов в месяц, 1200 кредитов, до 10 минут видео |
Агрегатор с оплатой по факту использования удобен для тестов нескольких моделей без покупки отдельных подписок, но не отменяет расчёт повторных попыток: если сцена не получилась с первого раза, кредиты или минуты списываются снова. Бесплатный тариф не всегда дешевле платного при серийном производстве — лимиты бесплатных версий быстро заканчиваются, а водяной знак на бесплатном экспорте делает материал непригодным для коммерческой публикации. Сделать ии видео со звуком и создать короткое видео с помощью нейросети в рамках бесплатного лимита подходит для теста идеи, но не для регулярного выпуска контента.
Как проверить права, безопасность и публикацию
Перед публикацией полезно пройтись по чек-листу: лицензия на использованные фотографии, согласие человека на использование его лица и голоса, права на фоновую музыку, отсутствие чужих товарных знаков в кадре, ограничения конкретной модели на коммерческое использование результата, условия хранения загруженных файлов сервисом и отдельные требования площадки публикации.
Техническая возможность создать материал и право его опубликовать — разные вещи. Сделать видео с помощью нейросети онлайн может любой пользователь, но это не означает автоматического права на коммерческое использование результата: часть моделей разрешает генерацию только для личных целей на бесплатном тарифе, а коммерческая публикация требует платной подписки или отдельной лицензии.
Для синтетического контента с реалистичными людьми действует отдельное правило: там, где правила площадки требуют раскрытия использования ИИ, материал нужно маркировать явно. Нельзя выдавать вымышленную сцену за реальное событие и нельзя заставлять реального человека говорить то, чего он не говорил, даже в развлекательном формате — это создаёт репутационный и юридический риск вне зависимости от намерений автора. Сделать ии видео со звуком с узнаваемым голосом публичного человека без согласия — частая причина удаления материала с площадки по жалобе.
Практическая рекомендация — хранить исходники, версии промптов, даты генераций и сведения о ручных правках в одном месте. Это помогает подтвердить происхождение материала при спорной ситуации и быстро воспроизвести удачный результат позже. Публикация материала в соцсети не делает его автоматически свободным для коммерческого использования — права на исходные фотографии, музыку и голос остаются за их владельцами независимо от того, где опубликован итоговый ролик.
Как выбрать сервис и улучшить результат в ModelStation
Последний практический шаг — выбор не самого громкого бренда, а модели под конкретную задачу и доступные входные данные. Создать видео ролик через нейросеть получится быстрее, если сравнивать модели по критериям, а не по маркетинговым обещаниям на главной странице.
Все ТОП нейросети в одном пространстве — ModelStation объединяет несколько моделей генерации видео в одном интерфейсе: каталог организован по задачам, доступно сравнение вариантов на одном и том же промпте, а оплата идёт по факту использования без покупки отдельной подписки под каждый сервис.
Редакционный алгоритм выбора простой: сначала один и тот же промпт тестируется на двух-трёх моделях, затем результаты сравниваются по стабильности движения, соответствию исходному изображению, наличию и качеству звука, скорости генерации, лимитам длительности и итоговым расходам в кредитах. Для короткого вертикального контента в приоритете скорость и правильный формат кадра. Для товара важнее всего сохранение внешности и формы предмета между дублями. Для аватара на первый план выходят голос, естественность мимики и права на использование лица. Для сложной многоплановой сцены решающими становятся связность между кадрами и управление движением камеры.
Агрегатор не скрывает различия моделей — наоборот, сравнение в одном пространстве делает разницу в качестве, скорости и цене видимой сразу, без переключения между десятком отдельных кабинетов и подписок. Это и есть практическая польза такого подхода: критерии сравнения остаются на стороне пользователя, а не растворяются в рекламных формулировках отдельных сервисов. Дополнительный обзор моделей и их возможностей собран в материале Бесплатные нейросети 2026: обзор сервисов | ModelStation.